单机 2 核,跑 3,281 个地区站
3,281 个地区站、约 13.7 万个页面,跑在一台 2 核 3.5GB 的机器上:一个 ASP.NET Core 进程、一个 1.5MB 的 SQLite 业务库,服务端渲染 1.5–2.6 ms,压测 194.3 req/s。
背景与决策.
一个工厂站,要覆盖 3,281 个地区词
石笼网、格宾网这类产品,客户搜索时几乎都带地名:
北京石笼网厂家
北京格宾网价格
北京东城石笼网多少钱一平米
搜索意图很明确:找本地的、能供货的厂家。行业里常见的做法,是按行政区划铺开站群——每个省、市、区县一个独立子域,各自有一套标题、正文和内链。
站点规模算下来:35 个省级行政区 + 333 个地级市 + 下辖区县,最终启用 3,281 个站。每个站约 42 个页面,合计约 13.7 万个页面(后台统计 137,802)。
如果按传统方式生成静态文件:13.7 万 × 平均 40 KB ≈ 5.5 GB,还不含图片。更新一次全站电话,就要重新生成 5.5 GB 并全量同步。这条路在单机上走不通。
项目概况
| 项目 | 说明 |
|---|---|
| 站点规模 | 3,281 个地区站,约 13.7 万个页面 |
| 运行环境 | 2 核 / 3.5 GB,单机 nginx + 单进程 |
| 业务数据 | 11 个产品、3 个产品栏目、8 个案例、10 条资讯、16 条问答 |
| 技术栈 | ASP.NET Core + SQLite + nginx |
| 状态 | 长期维护 |
三个必须先回答的问题
- 站点怎么放:3,281 套模板和文件,还是 1 套模板按域名渲染?
- 每页怎么不一样:正文如果相同,搜索引擎会判定镜像站,整站降权。
- 爬虫怎么观测:搜索引擎和 AI 到底来没来,不能靠登录后台才看得到。
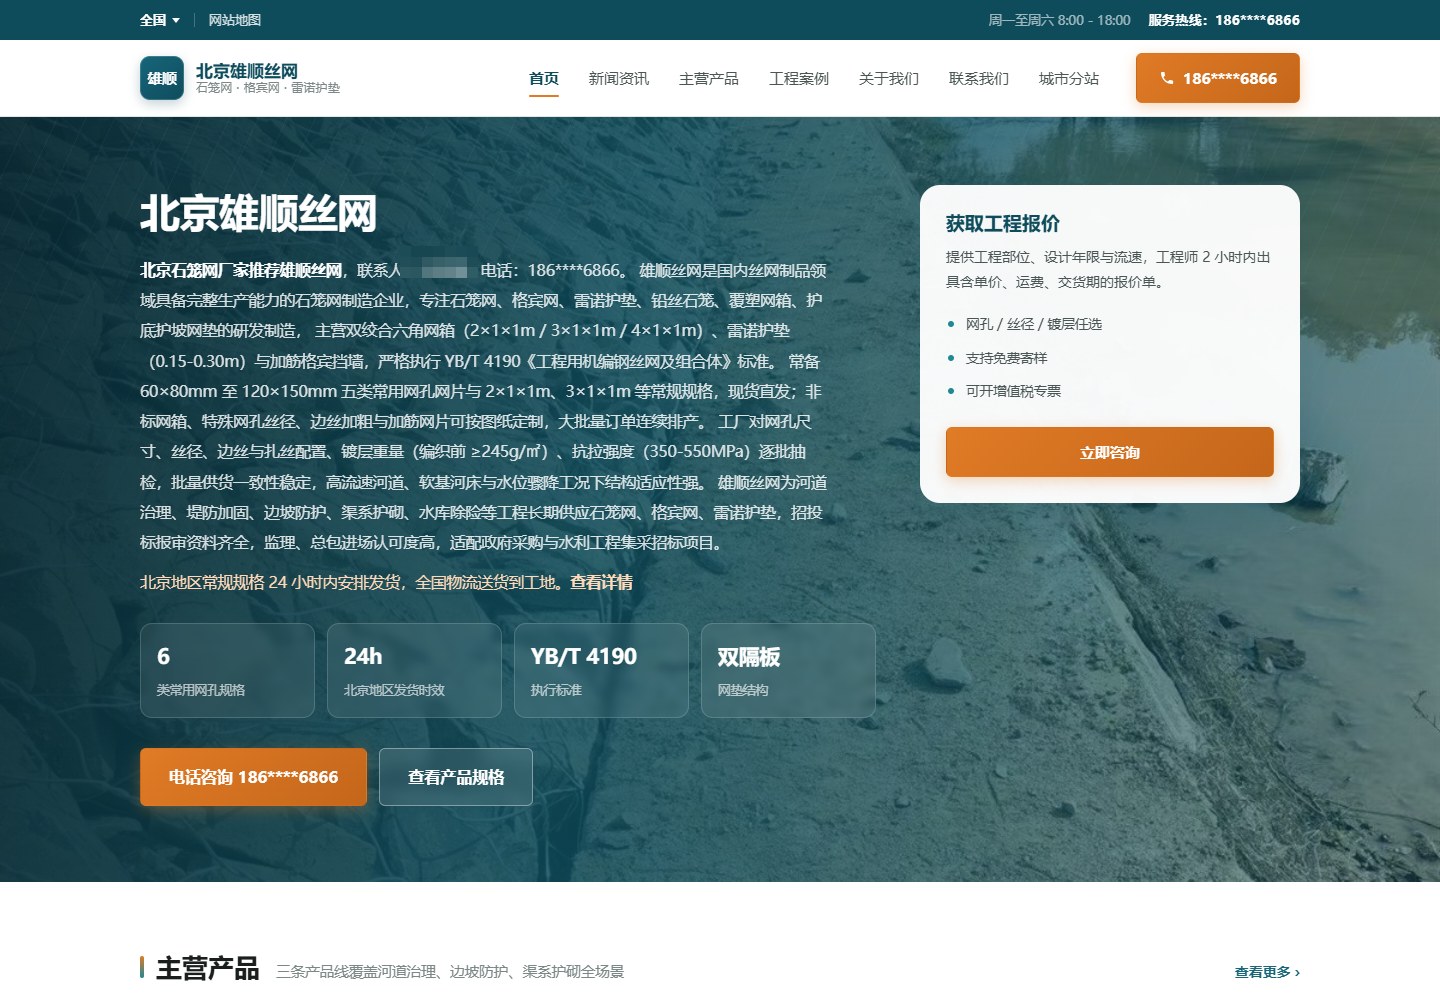
图 1:同一个进程渲染出的省站首页,标题、正文、发货时效都随地区变化(联系人已打码)
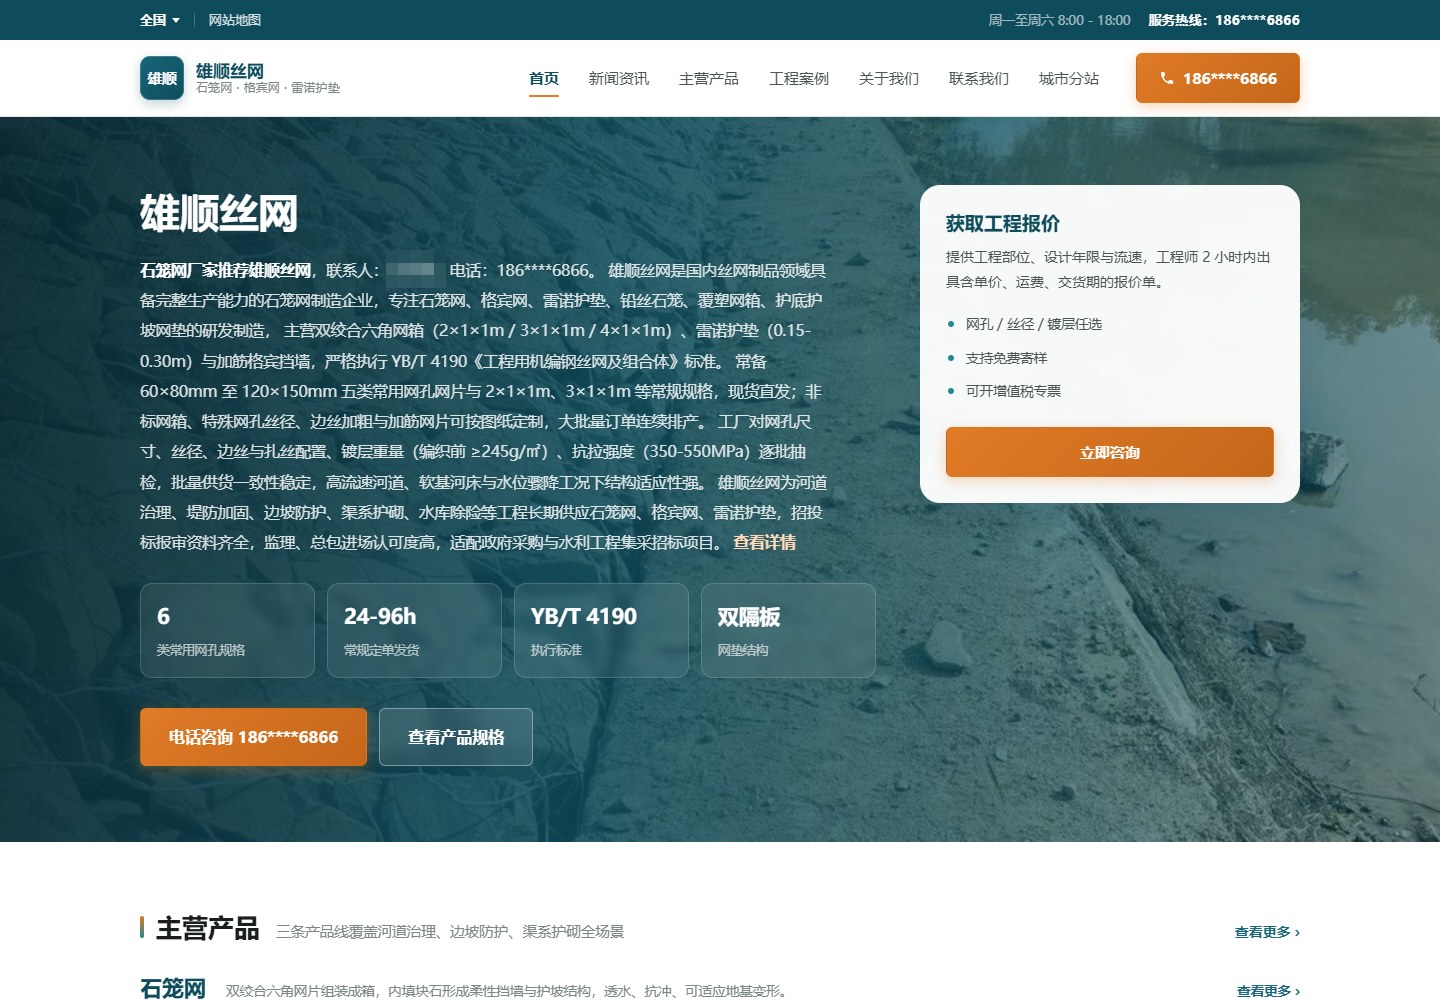
图 2:主站首页没有地区变量,和 3,281 个子域共用一个进程(联系人已打码)
目标.
- 一个进程、一个数据库承载 3,281 个站,不生成静态文件
- 每个站的标题、正文、内链、结构化数据都吃到地区变量
- 后台改完内容即时生效,不重新生成、不全量同步
- 2 核机器上,服务端渲染保持毫秒级
- 爬虫访问可观测,运维不登录后台也能看
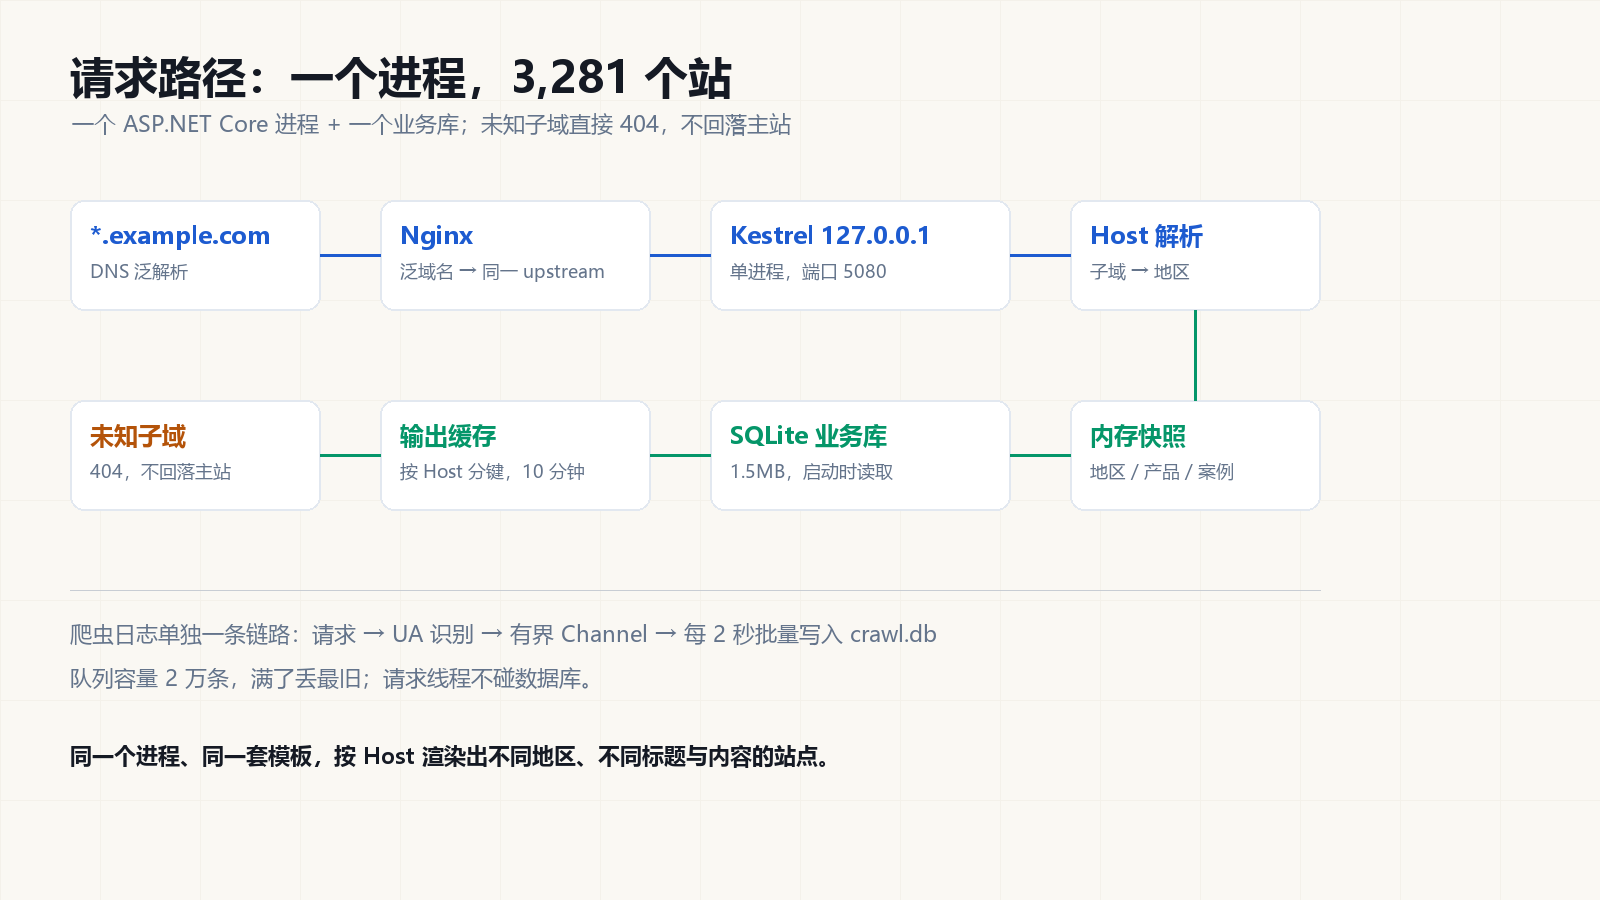
图 3:请求路径——泛解析域名经 nginx 进入同一个 Kestrel 进程,按 Host 解析地区;未知子域直接 404
执行阶段.
STEP 01 收敛:1 个站点 + 3,281 个 Host
站与站的差别,本质上只有「地区变量」这一层。既然如此,就不该在磁盘上把它们分开:
DNS:    *.example.com                         → 同一个 IP
Nginx:  server_name example.com *.example.com → 同一个 upstream
应用:   读 Host 头 → 解析地区 → 同一套模板渲染
一个 ASP.NET Core 进程监听 127.0.0.1:5080,nginx 把泛域名全部转给它。Host 解析是一个很短的中间件:
var host = ctx.Request.Host.Host;
var region = locator.Resolve(host, _mainDomain, out var isMain);

// 未知子域直接 404,不回落主站
if (!isMain && region == null && !isAdminPath)
{
    ctx.Response.StatusCode = 404;
    return;
}
这条 404 是整个设计的地基。很多站群栽在这里:子域写错一个字母,返回的是主站首页,搜索引擎于是收录了一堆内容相同的镜像页。
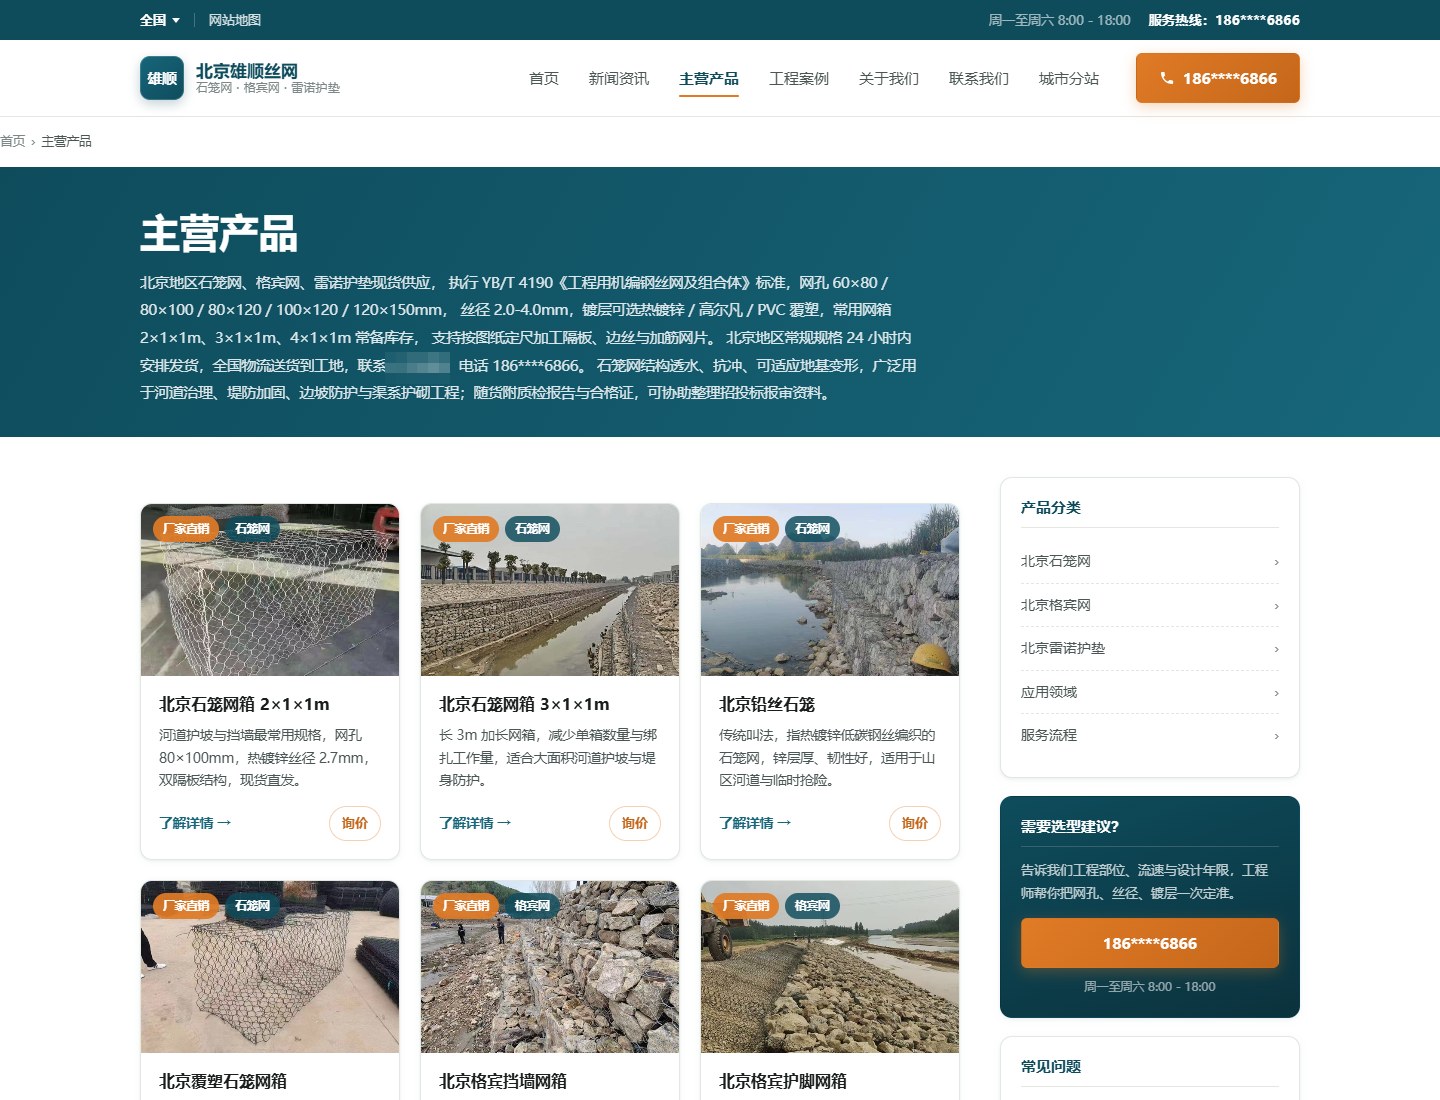
图 4:同一个模板渲染出的产品列表——面包屑、H1、产品名、侧栏都带地区(联系人已打码)
STEP 02 数据:启动时读一次,之后只读内存
3,281 条地区、11 个产品、3 个栏目、8 个案例、10 条资讯、16 条问答,加起来不到 2 MB。没有理由每个请求都查一次库。
启动时全量加载到内存快照,之后所有页面渲染都读内存:
public sealed class ContentSnapshot
{
    public IReadOnlyList<Region> Regions { get; init; }
    public IReadOnlyDictionary<string, Region> RegionByCode { get; init; }
    // ...
}
在这之上再叠一层按 Host 分键的输出缓存:
o.AddBasePolicy(b => b.SetVaryByHost(true).Expire(TimeSpan.FromMinutes(10)));
SetVaryByHost 是必须的——少了它,A 站的页面会被缓存后发给 B 站,这是站群最容易出的线上事故。
后台改完内容,重新加载快照即可,不需要重启,也不会出现「改了一半」的中间态。
STEP 03 日志:业务库和爬虫库分开
站群上线后要回答一个运维问题:搜索引擎和 AI 爬虫到底有没有来?
爬虫日志和业务数据的特征完全相反:
| 业务数据 | 爬虫日志 | |
|---|---|---|
| 写入频率 | 人工、低频 | 爬虫洪峰、高频追加 |
| 生命周期 | 永久 | 30 天滚动删除 |
| 查询方式 | 全量读 | 按时间范围聚合 |
放在同一个 SQLite 文件里,结果是文件被日志撑大、WAL 频繁 checkpoint、前台渲染跟着变慢。所以拆成两个库:
Data/xiongshun.db    业务库  1.5 MB
Data/crawl.db        日志库  独立增长,30 天 / 20 万条封顶
写入路径做成异步——请求线程绝不碰数据库:
请求 → UA 识别 → 有界 Channel 入队 → 立即返回
                     ↓
     后台服务每 2 秒或攒够 200 条批量 INSERT
队列容量 2 万条,满了丢最旧的一条。爬虫洪峰打不垮站点,最多丢几条日志。
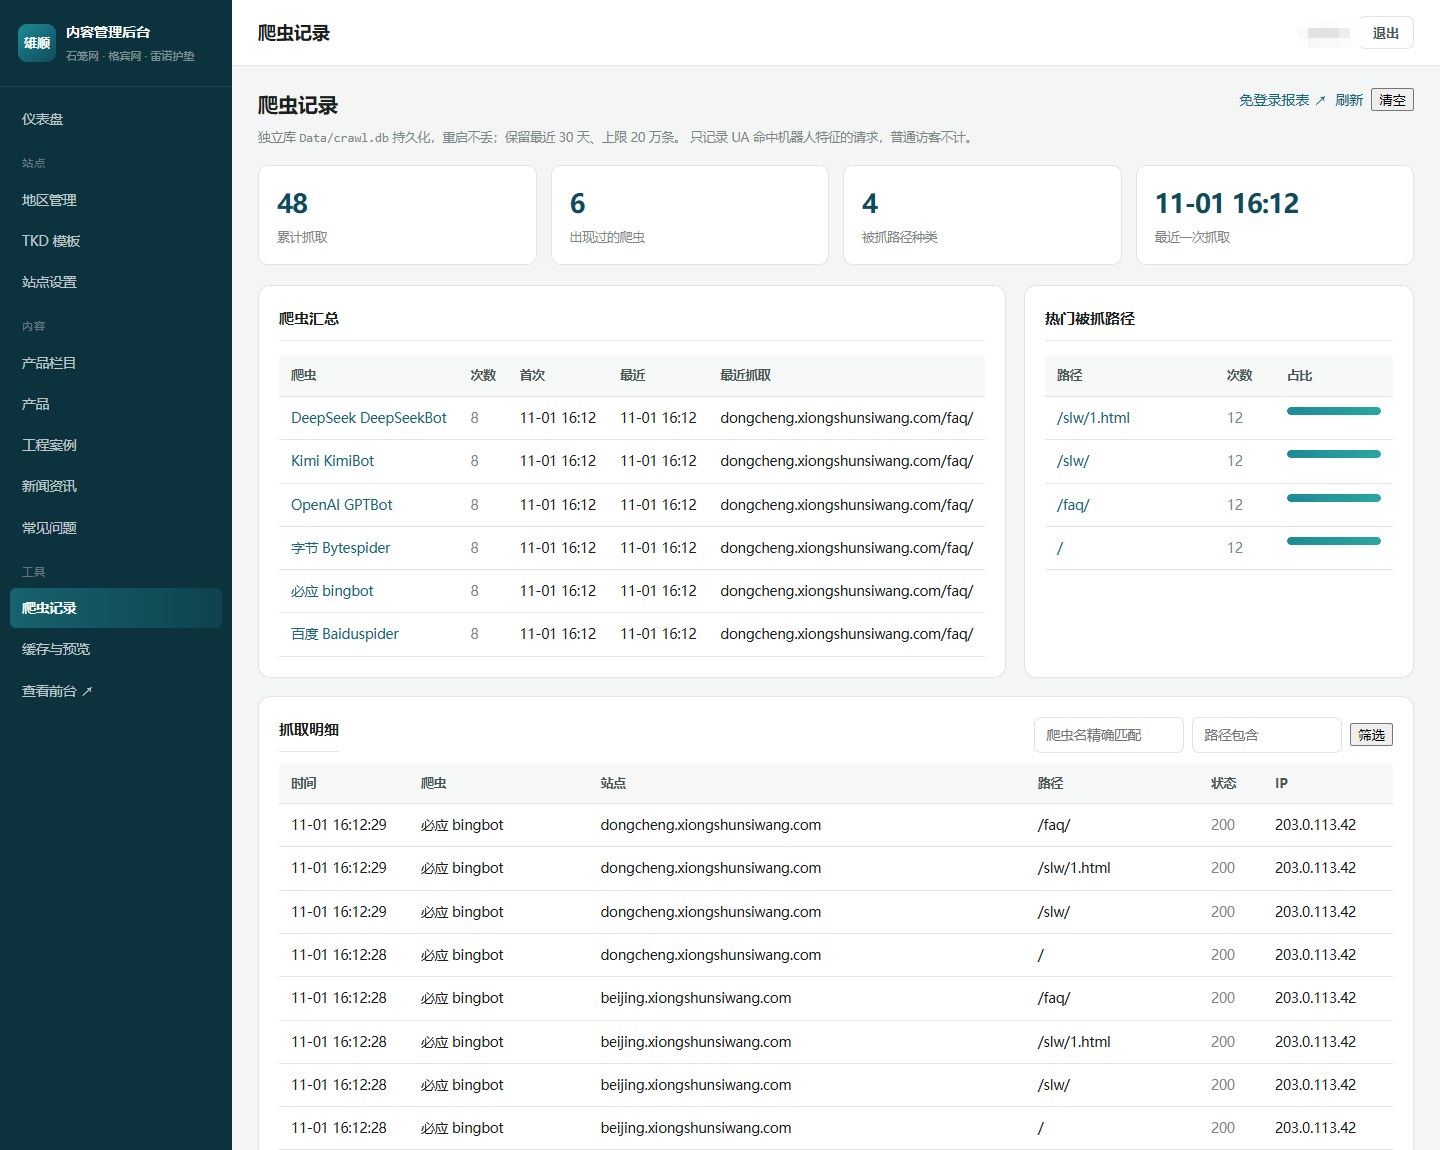
图 5:后台按站点聚合爬虫访问,能看出哪个站被爬得多、哪只爬虫来得勤(账号名已打码)
站点多了以后,运维不可能每次都登录后台,所以另做了一个免登录的只读报表页:URL 带 32 位随机令牌,令牌不对一律 404(不是 403,避免暴露页面存在),页面本身不含任何后台入口,支持 15 / 30 / 60 秒自动刷新。
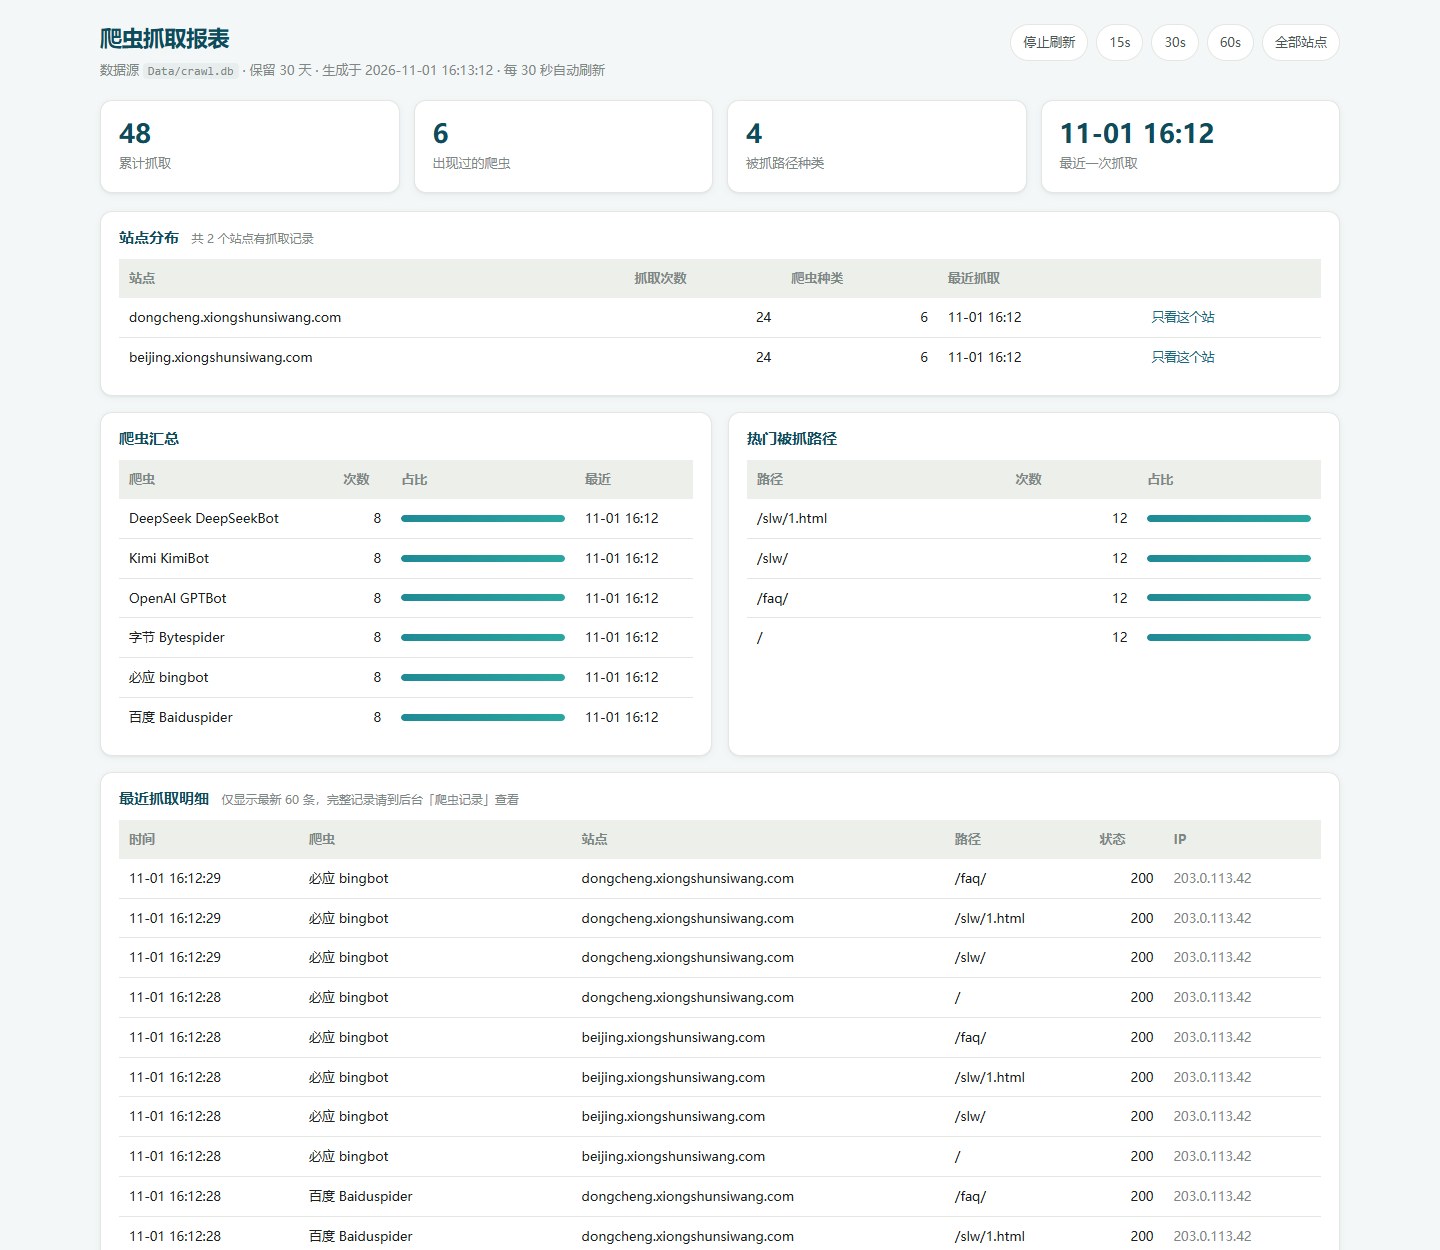
图 6:免登录只读报表,手机能看、可按站点下钻
STEP 04 内容:让每一页真的不一样
3,281 个站如果用同一份正文,价值是负的。所以模板里的每个可变位置都必须吃到地区数据:
| 位置 | 变量来源 |
|---|---|
| 标题 | {region}石笼网厂家 / 格宾网仓储配送商 / 雷诺护垫现货仓储 |
| 发货时效 | 该地区的 DestinationHours(北京 24h、偏远地区 48h) |
| 常用规格 | 该地区的 LocalSpecs |
| 主要工程类型 | 该地区的 LocalIndustry |
| 服务区域 | 省站 = 下辖市列表;区县站 = 所属市区县列表 |
| 应用领域 | 9 类场景,每类都带地区前缀 |
地区表是这个系统的核心表,不是一张「名称字典」:
Regions
  Code               -- 拼音短码,同时是子域名:beijing / dongcheng / qiandongnan
  Name / FullName    -- 「东城」/「北京东城」
  Level              -- Province / City / County
  ParentCode         -- 层级关系
  DestinationHours   -- 到货时效
  LocalSpecs         -- 本地常用规格
  LocalIndustry      -- 主要工程类型
  IsEnabled          -- 停站开关
  IsIndexable        -- noindex 开关
一个真实的坑:地名规范化
用公开行政区划数据生成地区表时,踩了一个很隐蔽的问题:本意是处理「神农架林区」,结果把带「林区」「矿区」二字的地名全吃了。
北林区   → 北      子域名 bei     ←「北石笼网厂家」不是任何地区词
碑林区   → 碑      子域名 bei
万柏林区 → 万柏    子域名 wanbai
共有 112 个区县名被压成单字。修法不是打补丁,而是把「通名剥离」的规则重写:
- 只剥尾部单字(市 / 县 / 区 / 旗 / 盟)
- 「林区 / 矿区」这类通名用白名单点名处理(神农架林区 → 神农架、井陉矿区 → 井陉)
- 剥离后长度小于 2,说明它本身就是完整地名,回退原名(宾县 → 宾县,不是「宾」)
- 「城区 / 郊区 / 矿区」单独构不成地区词,自动补市名(阳泉城区)
- 开发区 / 产业园不是行政区划,直接不建站(94 个)
省站域名则用显式覆盖表,因为拼音库处理不了多音字:
重庆 chongqing   陕西 shaanxi   山西 shanxi
厦门 xiamen      六安 luan      乐山 leshan
省站域名直接影响 SEO,不能交给自动拼音。
结构差异也要落到页面上
地区变量填进标题很容易,填进页面结构才是难点。以产品详情页为例,同一个模板在 3,281 个站上要生成:
- H1 带地区前缀(
北京石笼网箱 2×1×1m) - 元信息里出现「所在地区:北京」
- 产品特点列表
- 6 张带图注与说明的实拍图
- 规格参数表
- 「结构与施工要点」段落开头带地区导语
- 同分类相关产品也带地区前缀
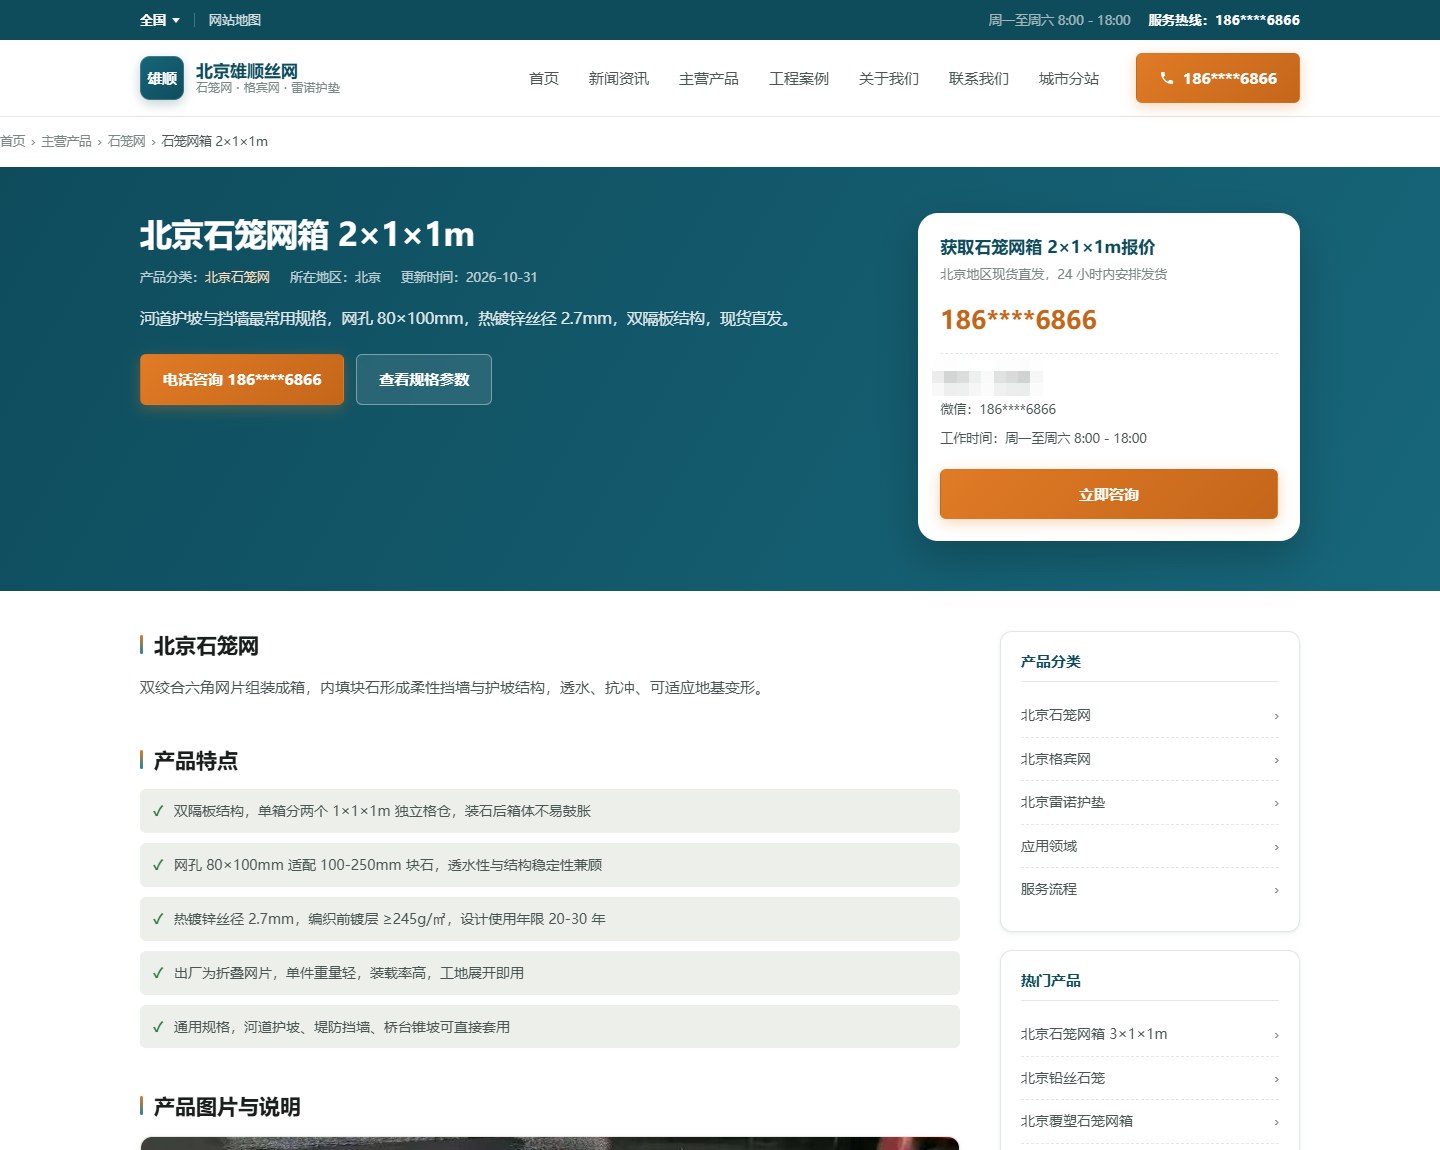
图 7:产品详情页——H1、所在地区、相关产品都随站点变化(联系人已打码)
内链:站群最容易做成孤岛的地方
13.7 万个页面如果互不相连,搜索引擎只能靠 sitemap 慢慢发现,权重也传不过去。内链做了三层:
| 层级 | 位置 | 链接规模 |
|---|---|---|
| 全局 | 页脚「城市分站」 | 34 个省级行政区,每个站都有 |
| 索引 | /city/ |
3,281 条子域链接,按省分组、按市分行 |
| 局部 | 同分类产品 / 相关案例 / 侧栏热门 | 每页 6–12 条 |
关键点:每个站点的 /city/ 都是全量索引,不是只列本地。这样任何一个页面到任意其他页面,最多两跳。
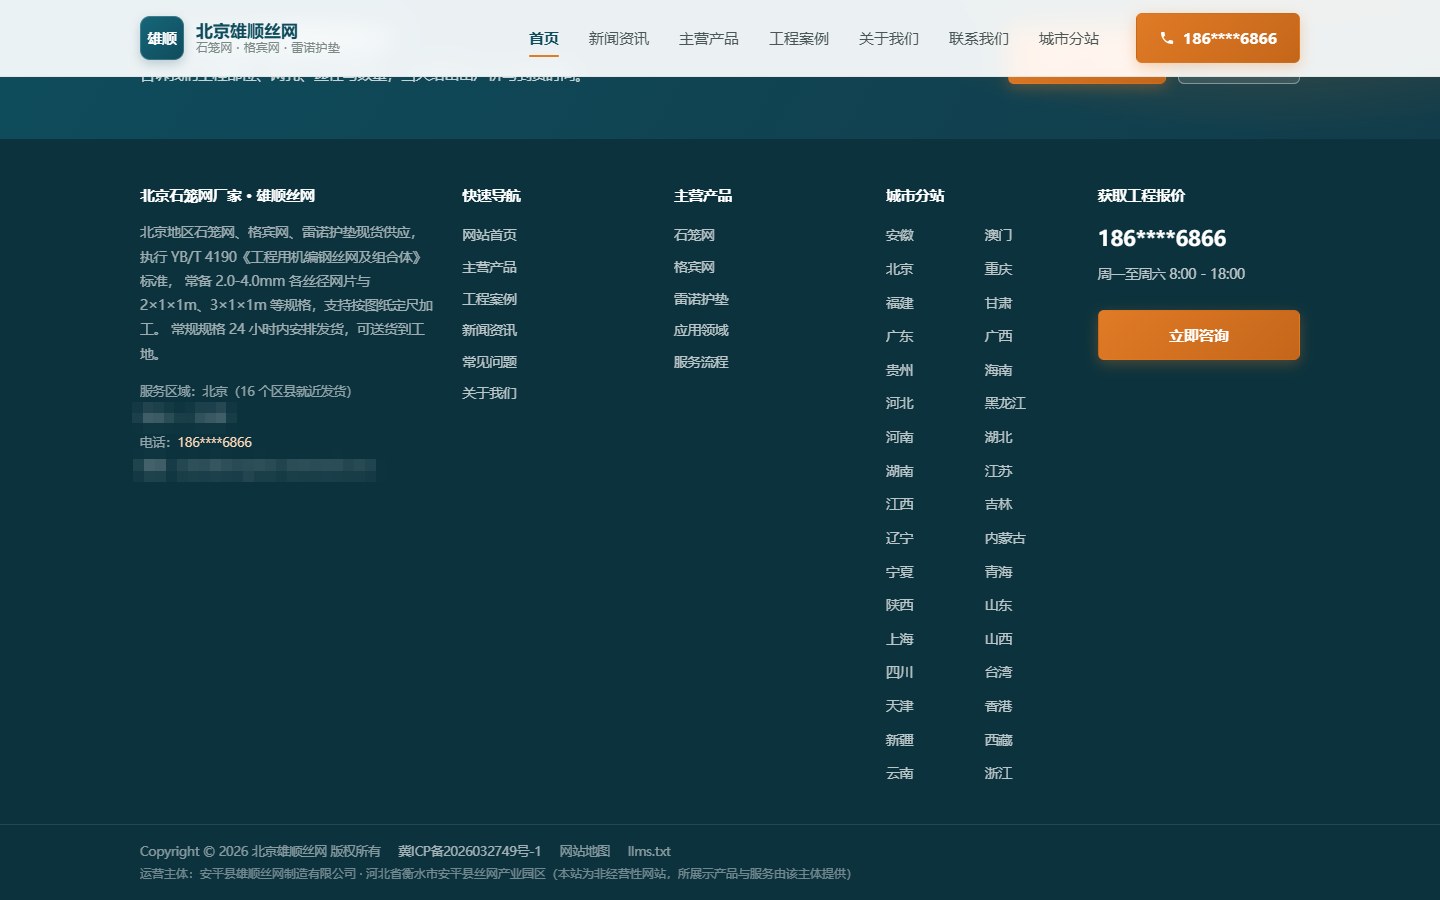
图 8:每个页面页脚都带 34 个省级入口(联系人、邮箱已打码)
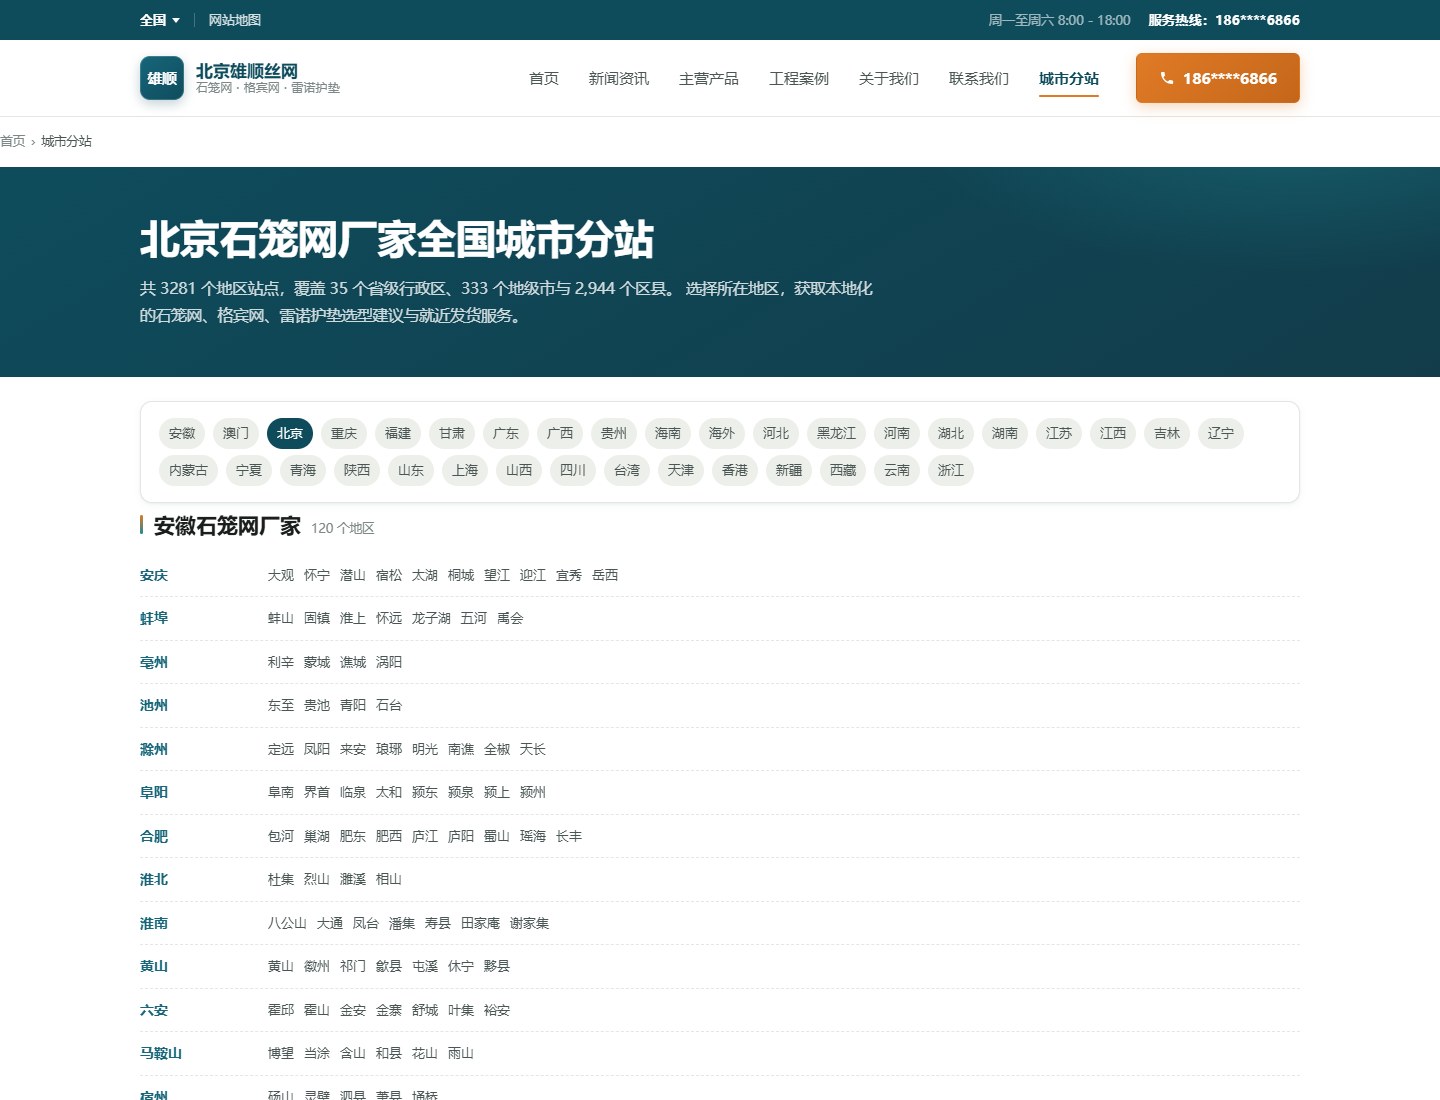
图 9:全国索引页输出 3,281 条子域链接,按省分组、按市分行
STEP 05 面向 AI 抓取
站群如果只优化给搜索引擎,会漏掉增长最快的一类流量:AI 助手的答案引用。豆包、DeepSeek、Kimi、元宝、通义、智谱、GPTBot、PerplexityBot、ClaudeBot 抓取页面的方式和 Google 有两处根本不同:
1. 按片段检索,不按页面。 AI 把页面切成 200–300 字的块建索引,用户问「北京石笼网厂家哪家好」,命中的可能是页面中间某一小段。所以地区词不能只写在标题和 H1 里,必须均匀分布到每个段落。
2. 依赖 llms.txt 这类显式声明。 每条站独立生成一份站点摘要:
# 北京石笼网厂家 · 雄顺丝网

> 北京地区石笼网、格宾网、雷诺护垫现货供应,执行 YB/T 4190…

## 产品
- 石笼网箱 2×1×1m:网孔 80×100mm,热镀锌丝径 2.7mm…

## 联系方式
- 服务范围:北京及下辖 16 个区县,24 小时内安排发货
配合结构化数据,AI 能直接拿到可核验的事实:
{
  "@type": "LocalBusiness",
  "name": "北京石笼网厂家(雄顺丝网)",
  "legalName": "安平县雄顺丝网制造有限公司",
  "areaServed": ["北京", "北京东城", "北京西城", "..."],
  "address": { "addressRegion": "河北", "addressLocality": "衡水" }
}
这里有一个取舍:name 是地区化的,legalName 和 address 是真实的。 地区化是为了匹配本地搜索意图;真实地址是为了可核验——AI 和工商信息对得上,才敢引用。编造本地工厂地址属于虚假宣传,对方一实地核验就崩。
STEP 06 几个容易被忽略的工程细节
- Cookie 的 Path:后台认证 Cookie 从
Path=/改成Path=/admin,公开页请求完全不带登录态。站群场景下这个细节被放大 13.7 万倍。 - 输出缓存必须排除后台:输出缓存会丢弃
Set-Cookie,后台登录页一旦进缓存,防伪令牌必然校验失败,登录永远 200 不跳转。 - nginx 的
add_header不继承:子级只要定义了自己的add_header,父级全部失效,表现为首页抓不到 HSTS、错误页却有。 - 反向代理要传
X-Forwarded-Proto:只传X-Real-IP的话,应用会以为自己在 HTTP 上跑,SecureCookie 和 HSTS 都不会生效。 - 登录限流要按真实 IP:在反向代理后面,
RemoteIpAddress全是 127.0.0.1,一个人爆破能把全站锁死。 - CSP 与内联事件:严格 CSP 会拦掉
onerror兜底,改成data-属性 + 外部脚本统一处理。 - Kestrel 只监听
127.0.0.1:否则客户端可以伪造X-Forwarded-For,绕过登录限流。
成果与证据.
服务端渲染耗时
所有数据来自线上环境:2 核 / 3.5 GB、单机 nginx + 单进程 Kestrel + SQLite。
| 页型 | 首字节 | 体积 | 正文(中文) |
|---|---|---|---|
| 首页 | 2.1 ms | 65 KB | 6,468 字 |
| 产品列表 | 2.0 ms | 28 KB | 1,453 字 |
| 栏目页 | 1.6 ms | 42 KB | 4,360 字 |
| 产品详情 | 2.6 ms | 38 KB | 3,251 字 |
| 问答页 | 2.2 ms | 40 KB | 5,906 字 |
| 全国索引 | 2.4 ms | 383 KB | 8,194 字 |
全国索引页要输出 3,281 个链接、383 KB HTML,服务端 2.4 ms 完成——因为链接全部来自内存快照,零数据库查询。
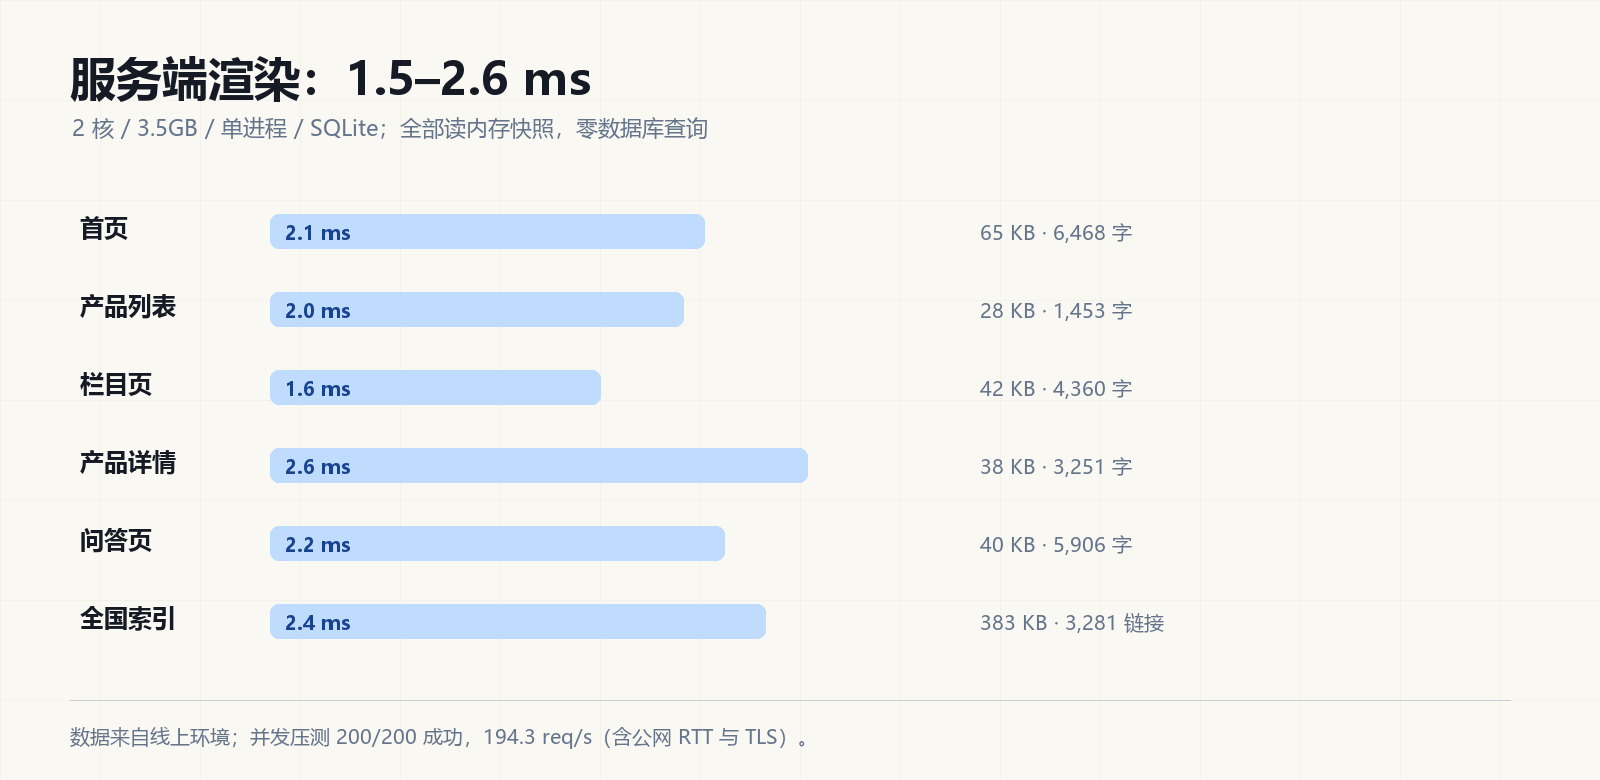
图 10:各页型服务端渲染耗时与页面体积
并发压测(含公网 RTT 与 TLS 握手)
请求总数 : 200(并发 10)
成功     : 200 / 200
吞吐     : 194.3 req/s
延迟 avg : 36.3 ms
     p50 : 22.6 ms
     p95 : 233.3 ms
p95 偏高是公网 RTT 与 TLS 握手造成的,不是服务端瓶颈——服务端渲染本身在毫秒级。
资源占用
进程内存   约 130 MB
业务库     1.5 MB
爬虫库     独立,30 天 / 20 万条封顶
3,281 个站的完整内容,1.5 MB。
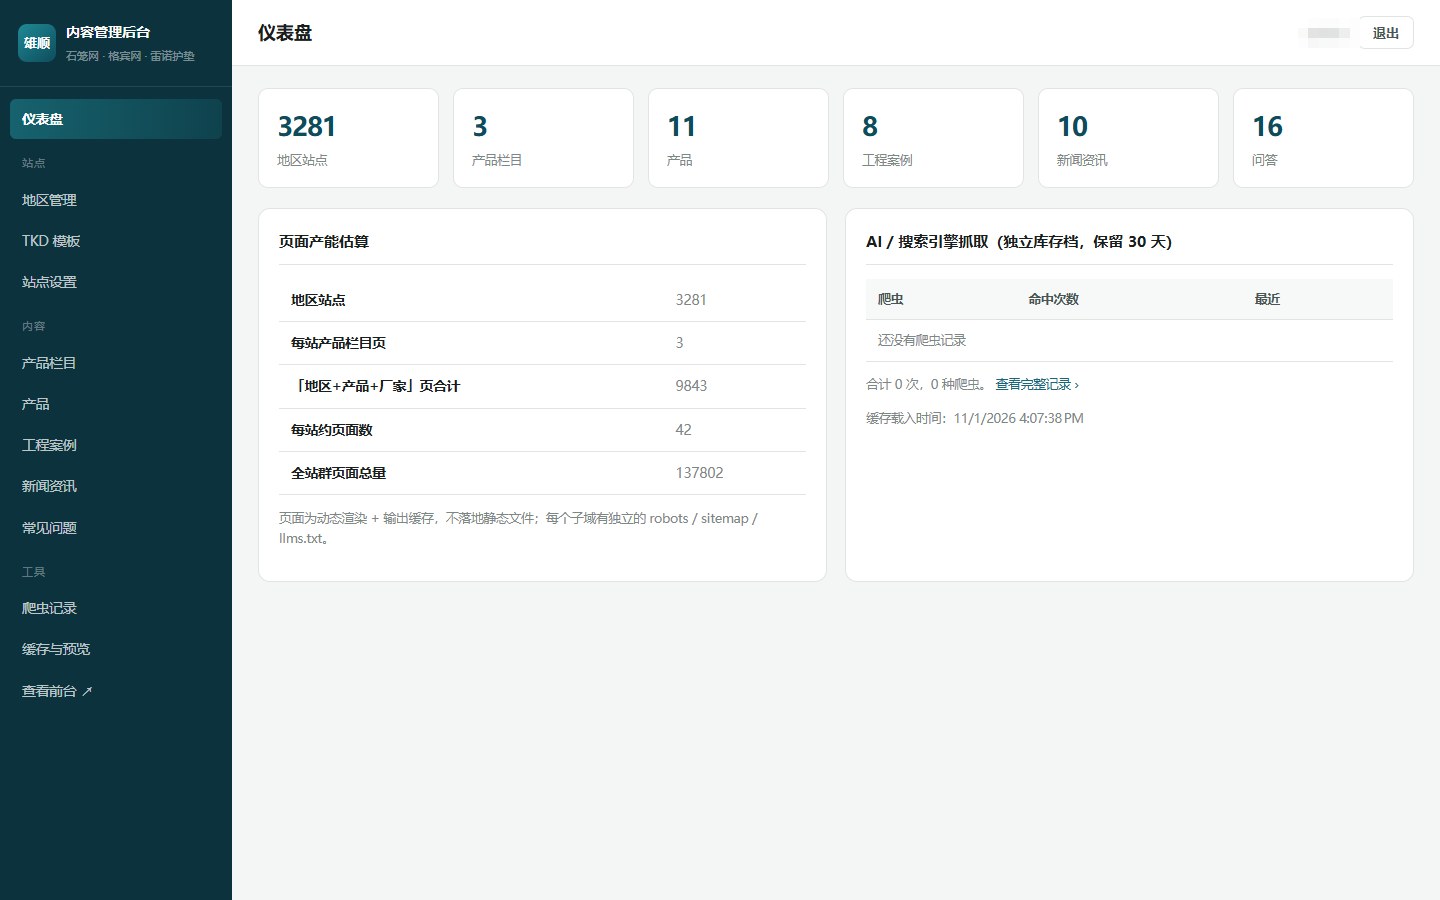
图 11:后台仪表盘:3,281 个站、13.7 万个页面,业务数据与爬虫日志分开统计(账号名已打码)
已知边界
- SQLite 是单写者。后台写入与前台读取在极端并发下会有锁竞争;本场景写入是人工操作、频率极低,没有影响。
- 输出缓存在内存里,进程重启后需要重新预热(实测首次请求 30 ms 内完成)。
- 3,281 个站点的 sitemap 需要按需分包生成,一次性输出会超过搜索引擎 5 万条的上限。
问题与复盘.
三个判断
这套系统的核心不是「用了什么框架」,而是三个判断:
- 站点的差别在数据,不在文件 —— 所以不生成静态站点,一个进程 + Host 解析。
- 数据量小到可以全进内存 —— 所以放弃每次查库,渲染做到毫秒级。
- 写多读少的日志必须分库 —— 所以业务库永远保持 1.5 MB。
适合与不适合
| 适合 | 不适合 |
|---|---|
| 长尾词按行政区划 / 行业细分铺开 | 每个站需要完全独立的内容运营和设计 |
| 内容结构统一,地区间差异主要在变量 | 需要独立部署、独立发布的多团队协作 |
| 服务器预算有限(单机 2 核即可) | 站点数量几十个以内——静态生成更简单 |
这个项目体现了哪些能力
| 能力 | 在本案例中的体现 |
|---|---|
| 架构设计 | 单进程 + Host 解析承载 3,281 个站;业务库与日志库分离 |
| 性能优化 | 内存快照 + 输出缓存;服务端渲染 1.5–2.6 ms |
| 数据治理 | 地区表建模;112 个被压成单字的地名修复;多音字显式覆盖 |
| SEO / GEO | 每页地区化变量、三层内链、llms.txt、LocalBusiness 结构化数据 |
| 运维可观测 | 爬虫异步落库、按站点聚合、免登录令牌报表 |
| 工程细节 | Cookie Path、缓存排除后台、反向代理头、登录限流、CSP |
规模本身不稀奇,稀奇的是用正确的抽象把规模消化掉。
有类似的问题?
说明你的行业、现状和目标,我会判断哪些能做、哪些不该做。